OrcaRouter / NVIDIA
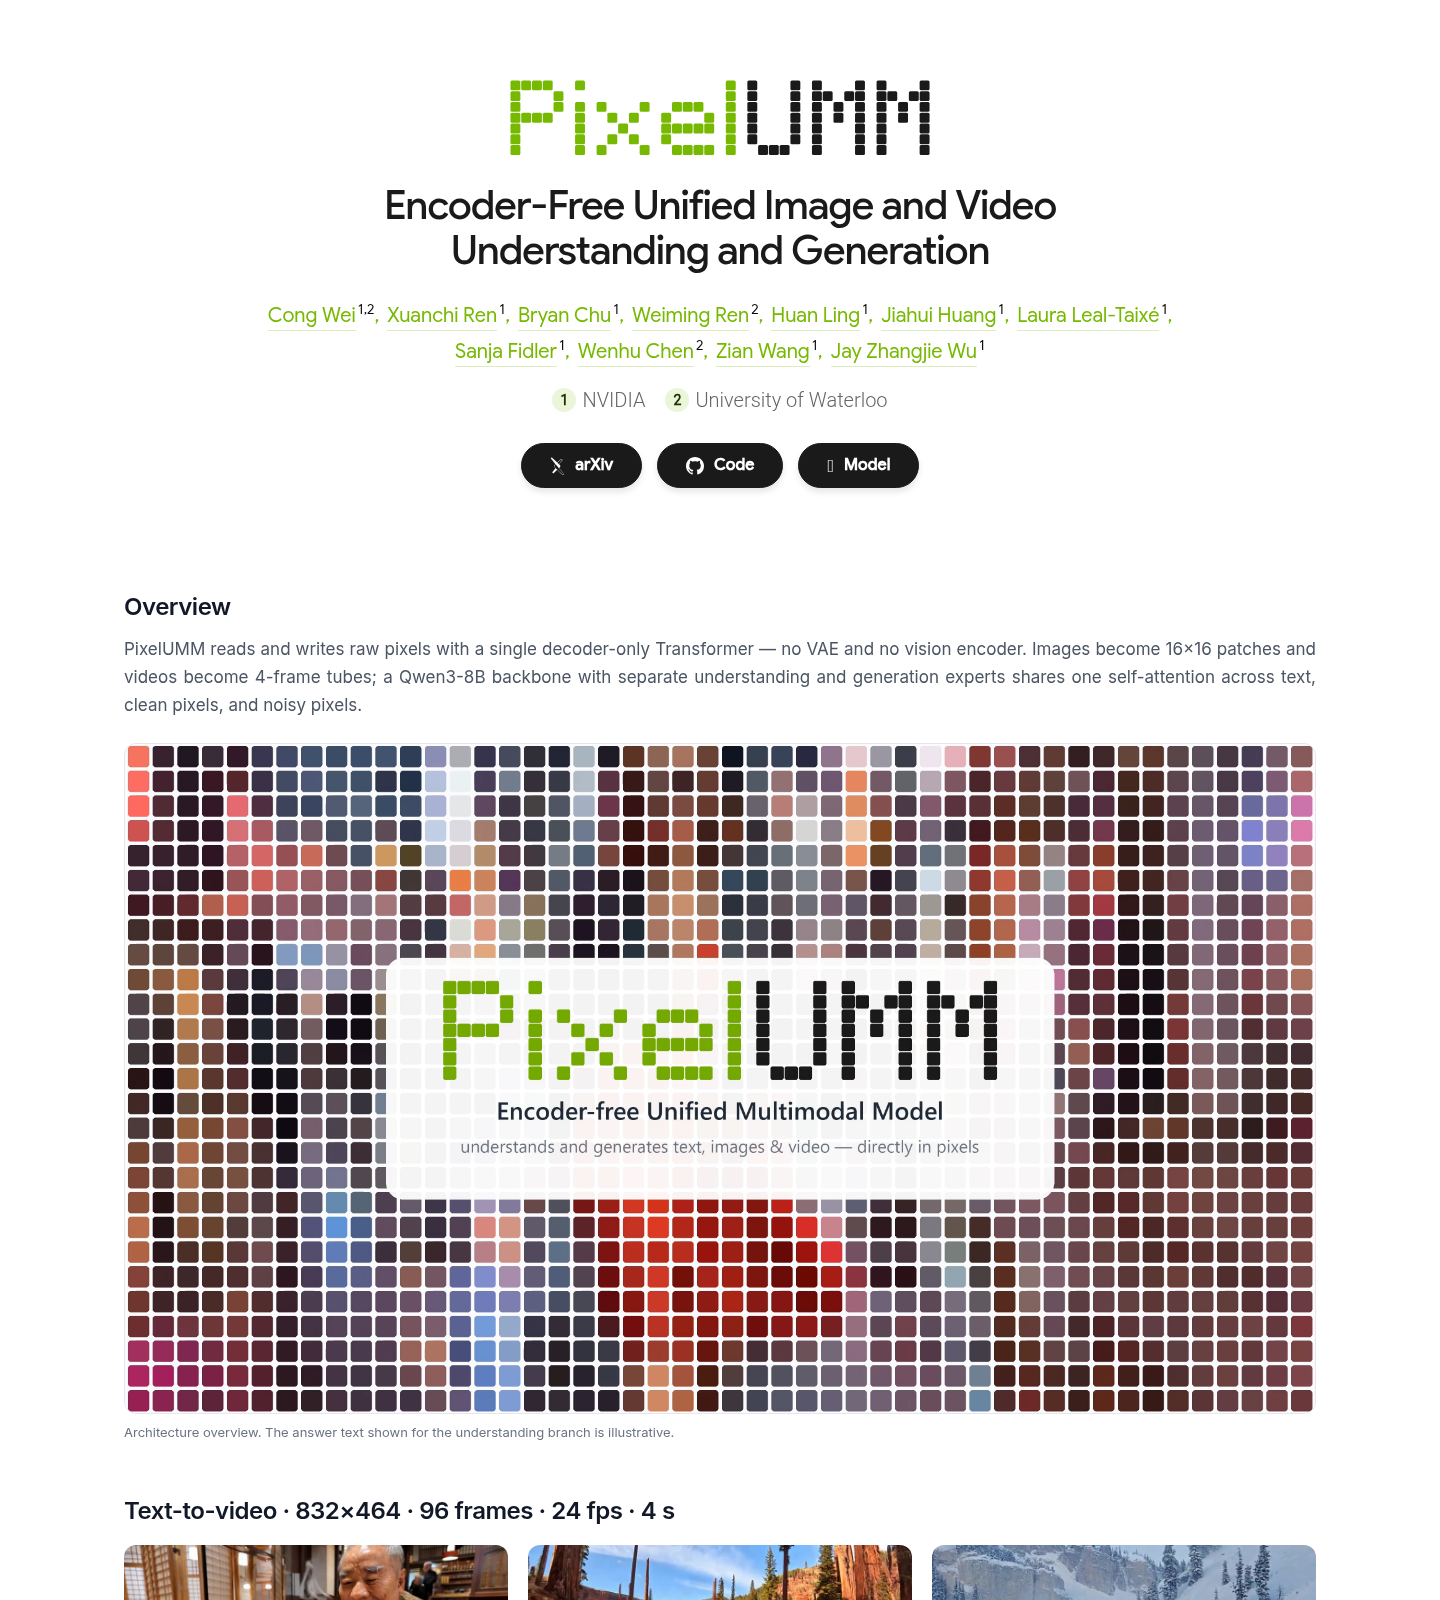
NVIDIA 静默发布 PixelUMM:无编码器统一图像与视频理解生成模型
背景
NVIDIA T-Labs 与 Waterloo 大学发布 PixelUMM,相关论文与权重在 9 月底至 10 月初陆续公开,未做正式发布。
核心要点
- PixelUMM 去除传统 VAE 与视觉编码器:图像切 16×16 像素块、视频切 4 帧时空 tubelet,仅经单层线性投影进入主干。
- 主干为基于 Qwen3-8B 的 decoder-only Transformer,配迭代式像素生成头(Mixture-of-Transformers)。
- 论文 arXiv:2609.38597(2026-09-29),GitHub nv-tlabs/PixelUMM 于 9 月 28–29 日提交,10 月 1 日权重上线 HF。
- 代表「像素直通」统一架构方向,降低多模态模型对独立视觉前端的依赖。
为什么重要
统一理解与生成、去掉视觉编码器,是简化多模态栈的重要探索;NVIDIA 以静默发布+开源权重的方式把研究工件直接推向社区。
关键事实速记
- 方向:encoder-free 统一图像/视频理解与生成
- 架构:像素块直入 Qwen3-8B decoder-only
- 论文:arXiv 2609.38597(2026-09-29)
- 权重:2026-10-01 上线 Hugging Face
- 归属:NVIDIA T-Labs × Waterloo
📂 原文链接:查看原文 →
← 返回资讯列表
AI8899 · 内容仅供学习参考