|
arXiv 新作:k1:k2 重归一化免训练减半激活专家,Qwen3.6 仅掉 0.35 MMLU
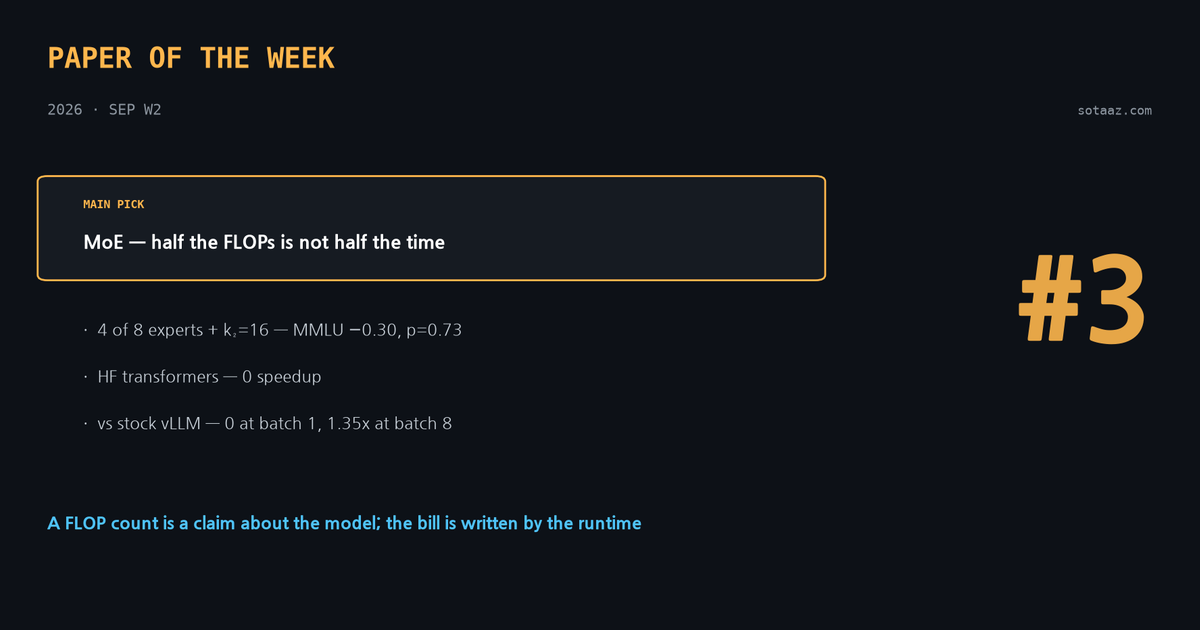
一句话:9 月 9 日,SOTAAZ 实测复现 arXiv:2609.04575:细粒度 MoE 用 k1:k2 重归一化,Qwen3.6-35B-A3B 在 4:16 专家下仅掉 0.35 MMLU;并戳破省 FLOPs=省时间的误区(批 1 无加速、批 8 仅 1.35×)。
背景
2026 年 9 月 4 日提交 arXiv:2609.04575(SOTAAZ 于 9/3–9/9 实测复现)。细粒度 MoE 路由取 top-k 并对概率归一;训练在该归一化下把专家分支增益校准到训练 k,推理减 k 同时改变分支响度与成员。修复:激活 top-k1 专家、除以 top-k2 质量(k2=16 时近乎不重归一化)。Qwen3.6-35B-A3B:4/8 专家标准归一化掉 4.65 MMLU 点、k2=16 仅掉 0.35。SOTAAZ 在 1×A100 复现到位(4:16 差 0.30pp,McNemar p=0.73);并实测墙钟:HF transformers 批 1 无加速、vLLM 批 1 无加速、批 8 仅 1.35×——效率论文常只报省下的 FLOPs 而漏报时间。
核心要点
- 9-4 arXiv:2609.04575(SOTAAZ 复现)
- k1:k2 重归一化(k2=16 近乎不重归一化)
- Qwen3.6-35B 4:16 仅掉 0.35 MMLU
- SOTAAZ 1×A100 复现差 0.30pp
- 墙钟:批 1 无加速、批 8 仅 1.35×
- 揭示省 FLOPs ≠ 省时间
为什么重要
用一整数、零训练减半专家计算并几乎不失准,是极简推理优化;SOTAAZ 同时戳破效率论文只报分母(FLOPs)不报分子(时间)的误区,提醒以真实运行时计账,对 serving 栈选型有现实意义。
关键事实速记
- 提交:2026-09-04
- arXiv:2609.04575
- 模型:Qwen3.6-35B-A3B
- 4:16 掉:0.35pp
- 复现:0.30pp
- 墙钟:批 8 仅 1.35×
← 返回资讯列表
AI8899 · 内容仅供学习参考