|
arXiv 新作 Declarative Attention:让 LLM 声明要读哪段上下文,解码 token 减少 52%
一句话:9 月 2 日,KAIST AI 与 Google DeepMind 的 arXiv 论文提出 Declarative Attention:让模型在思维链中声明要读取的上下文区域,Gemma-4-31B 解码注意力 token 减少 52%,准确率仅降 1.27pp。
背景
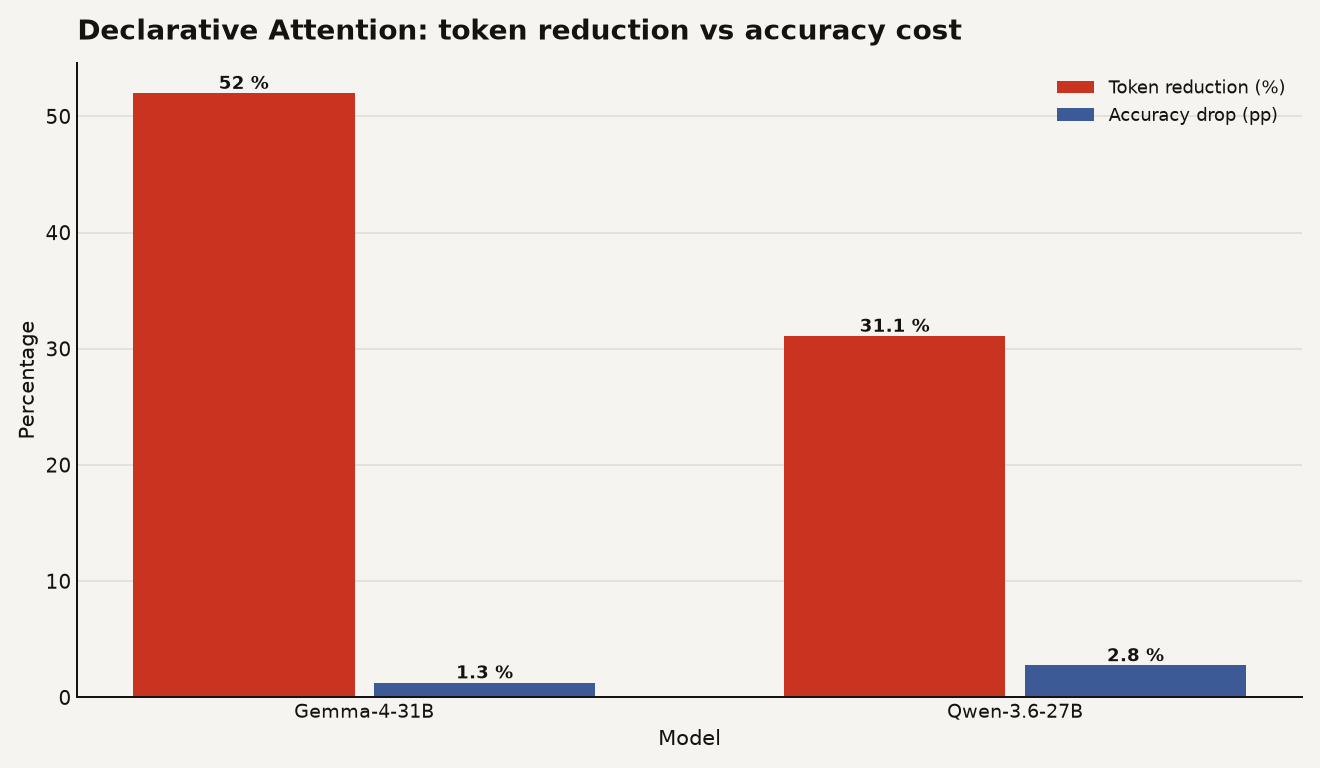
2026 年 9 月 2 日,KAIST AI 与 Google DeepMind 研究者发布 arXiv 论文(2609.02737),提出 Declarative Attention 协议,解决百万级上下文推理的 KV 缓存瓶颈。传统做法每生成一个 token 都要扫描整段历史(1M 上下文约 15GB KV 缓存);该协议让模型在自己的思维链中以类 XML 标签声明下一步要读哪段上下文,推理引擎像工具调用一样解析声明并跳过其余 KV 块。在 Gemma-4-31B 上,解码注意力 token 减少 52.0%,15 项长上下文任务平均准确率仅降 1.27pp;Qwen-3.6-27B 减少 31.1%、降 2.75pp。无需微调,已与 vLLM 高效注意力内核集成。
核心要点
- Declarative Attention 把瓶颈变提示问题
- 模型声明要读哪段上下文(XML 标签)
- 引擎跳过其余 KV 块,降内存读取
- Gemma-4-31B 注意力 token -52%,准确率 -1.27pp
- Qwen-3.6-27B -31.1%,-2.75pp
- 无需微调,已接 vLLM
为什么重要
长上下文推理的成本主要来自每步全量 KV 扫描;让模型「自己决定读什么」可大幅削减算力,使百万级上下文在消费级部署成为可能。该方法零微调、即插即用,是推理优化的实用突破,对 agent 长程记忆与检索场景尤其关键。
关键事实速记
- arXiv:2609.02737
- 发布:2026-09-02
- 机构:KAIST AI + DeepMind
- Gemma-4-31B:注意力 -52%
- 准确率损失:1.27pp
- 集成:vLLM,无需微调
📂 原文链接:查看原文 →
← 返回资讯列表
AI8899 · 内容仅供学习参考